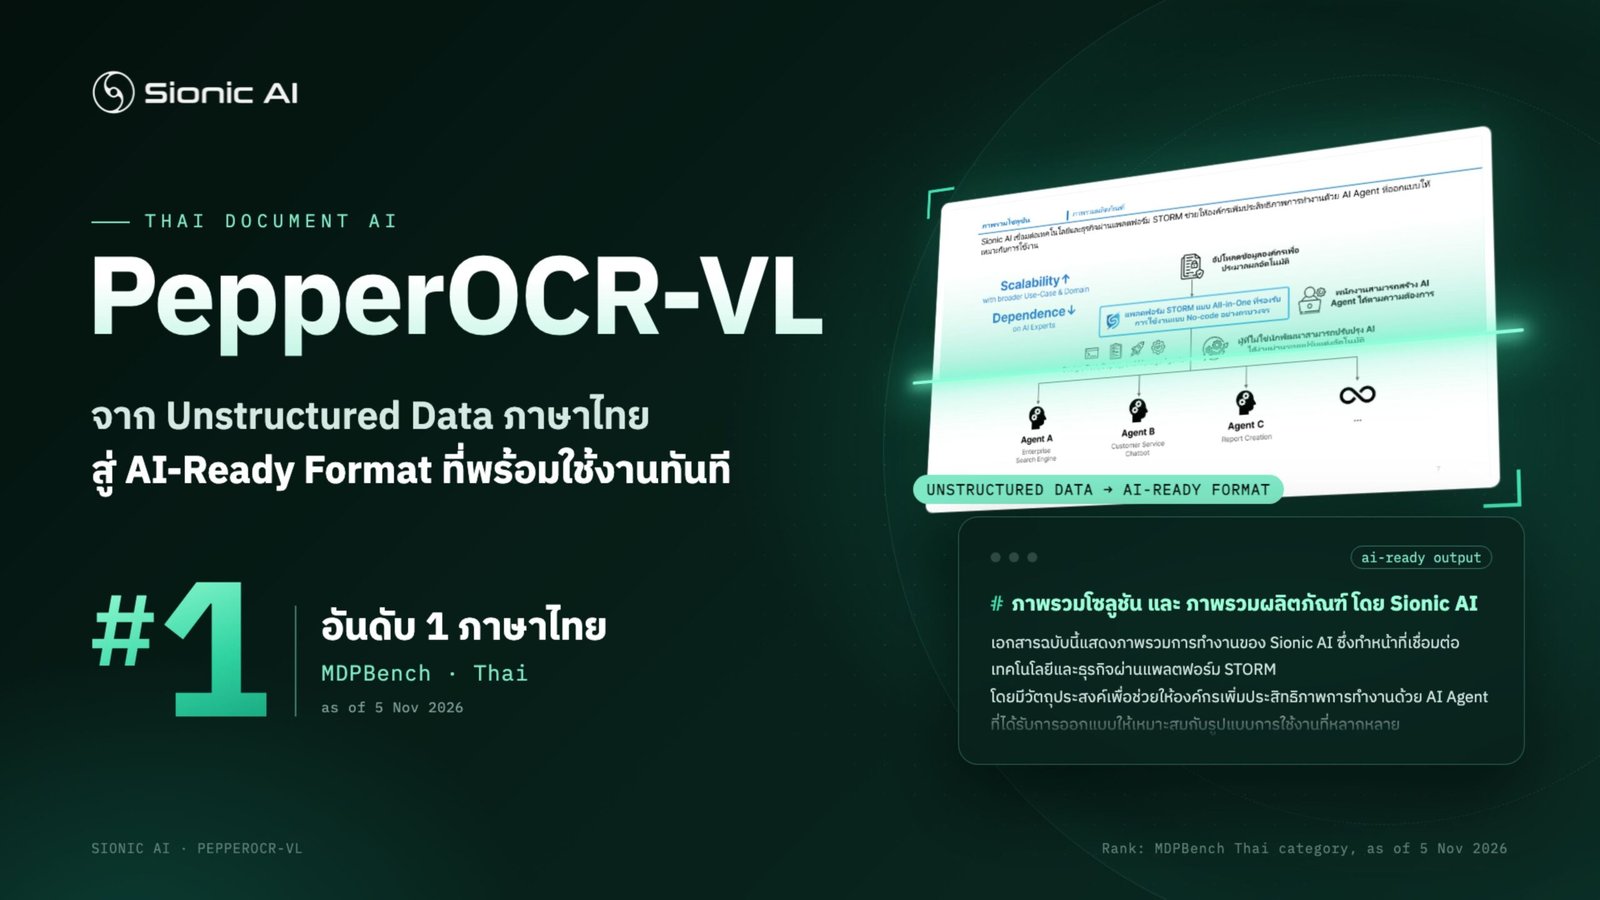
- เฉือนชนะโมเดลยักษ์ใหญ่ระดับโลกอย่าง Google Gemini 3 Pro ในหมวดการประมวลผลภาษาไทย จากเบนช์มาร์กที่ได้รับการยอมรับในเวทีระดับโลกอย่าง NeurIPS 2026
- อ่านเอกสารภาษาไทยจากภาพถ่ายมือถือได้อย่างแม่นยำ พร้อมผลักดันองค์กรภาครัฐและการเงินไทยสู่ยุคดิจิทัล (Digitization)
Sionic AI บริษัทผู้พัฒนาเทคโนโลยีปัญญาประดิษฐ์สำหรับองค์กรจากประเทศเกาหลีใต้ ประกาศความสำเร็จครั้งสำคัญหลังโมเดลประมวลผลและรู้จำเอกสาร “PepperOCR” คว้าอันดับ 1 ในหมวดหมู่ภาษาไทยจากการประเมินผลบน MDPBench ซึ่งเป็นเบนช์มาร์กวัดประสิทธิภาพการเข้าใจเอกสารหลายภาษา (Multilingual Document Understanding) ระดับสากล ส่งผลให้ทำคะแนนแซงหน้าโมเดลของบรรดาบริษัทเทคโนโลยีชั้นนำระดับโลกอย่าง Google Gemini 3 Pro
MDPBench ได้รับการพัฒนาโดยทีมวิจัยผู้อยู่เบื้องหลัง OCRBench ซึ่งเป็นมาตรฐานการทดสอบระบบรู้จำข้อความที่เป็นที่ยอมรับอย่างกว้างขวาง และผลงานวิจัยนี้ยังได้รับการคัดเลือกให้ตีพิมพ์ในสาย Datasets & Benchmarks Track ของงานสัมมนาวิชาการด้าน AI ชั้นนำของโลกอย่าง NeurIPS 2026 อีกด้วย เบนช์มาร์กดังกล่าวใช้ประเมินความสามารถในการเข้าใจเอกสารครอบคลุมถึง 17 ภาษา โดยทดสอบกับเอกสารที่ใช้งานจริงในชีวิตประจำวัน ไม่จำกัดเพียงแค่ไฟล์ดิจิทัล แต่ยังรวมถึงภาพถ่ายจากกล้องสมาร์ตโฟน ยิ่งไปกว่านั้น คะแนนทดสอบของ PepperOCR ยังผ่านการตรวจสอบและประเมินผลซ้ำอย่างเป็นกลางจากทีมผู้ดำเนินการเบนช์มาร์กโดยตรง
ภาษาไทยถือเป็นหนึ่งในภาษาที่ท้าทายที่สุดสำหรับการประมวลผลและอ่านเอกสาร เนื่องจากมีโครงสร้างสระและวรรณยุกต์ที่ซ้อนกันทั้งด้านบนและด้านล่างของพยัญชนะ ประกอบกับการเขียนแบบไม่เว้นวรรคระหว่างคำ ซึ่งมักทำให้ระบบอ่านข้อความทั่วไปเกิดข้อผิดพลาดบ่อยครั้ง และความแม่นยำจะลดลงอย่างเห็นได้ชัดเมื่อต้องประมวลผลจากภาพถ่ายเอกสารผ่านมือถือที่มีความเอียงหรือแสงเงาไม่สม่ำเสมอ PepperOCR จึงถูกพัฒนาขึ้นมาเพื่อแก้ปัญหาเหล่านี้โดยเฉพาะ สามารถอ่านเอกสารภาษาไทยที่มีความซับซ้อน เช่น แบบฟอร์มราชการ ใบแจ้งหนี้ สัญญา และเอกสารงบการเงิน ได้อย่างแม่นยำ พร้อมแปลงข้อมูลให้อยู่ในรูปแบบข้อความและตารางที่พร้อมนำไปใช้งานต่อได้ทันที
จุดเด่นสำคัญอีกประการของ PepperOCR คือขนาดของโมเดลที่กะทัดรัด (Compact size) องค์กรในไทยสามารถนำโมเดลไปติดตั้งใช้งานบนเซิร์ฟเวอร์ภายในองค์กร (On-premise) ได้โดยตรง ช่วยให้ข้อมูลที่เป็นความลับหรือข้อมูลอ่อนไหวไม่รั่วไหลออกนอกเครือข่ายภายใน ตอบโจทย์ความต้องการสูงสุดสำหรับกลุ่มธุรกิจธนาคาร ประกันภัย โรงพยาบาล และหน่วยงานภาครัฐที่ต้องดูแลข้อมูลส่วนบุคคล นอกจากนี้ โมเดลยังเปิดให้ใช้งานในรูปแบบโอเพนซอร์ส (Open Source ภายใต้สัญญาอนุญาต AGPL-3.0) บนแพลตฟอร์ม Hugging Face เพื่อให้นักพัฒนาและภาคธุรกิจไทยสามารถดาวน์โหลดไปทดสอบใช้งานได้ฟรี
การอ่านและแปลงเอกสารได้อย่างแม่นยำถือเป็นด่านแรกของการนำ Generative AI มาใช้งานในระดับองค์กร เนื่องจากข้อมูลส่วนใหญ่ในองค์กรจัดเก็บอยู่ในรูปแบบที่ไม่มีโครงสร้าง (Unstructured Data) เช่น เอกสารกระดาษ ไฟล์สแกน สัญญา และรายงานต่างๆ การที่ระบบ AI ภายใน หรือระบบสืบค้นข้อมูลความรู้ขององค์กร (RAG – Retrieval-Augmented Generation) จะตอบคำถามได้อย่างถูกต้องน่าเชื่อถือนั้น จำเป็นต้องเริ่มต้นจากการแปลงเอกสารเหล่านี้ให้เป็นข้อมูลที่มีโครงสร้างและมีความถูกต้องสูง หากข้อมูลนำเข้าผิดพลาดตั้งแต่ต้น ความน่าเชื่อถือของผลลัพธ์ที่ AI สร้างขึ้นก็จะลดลงตามไปด้วย การแปลงเอกสารที่ซับซ้อนให้กลายเป็นข้อความและตารางที่สมบูรณ์ของ PepperOCR จึงช่วยให้องค์กรในไทยสามารถเปลี่ยนคลังเอกสารที่มีอยู่เดิม ให้กลายเป็นสินทรัพย์ดิจิทัลที่พร้อมป้อนเข้าสู่ระบบ AI ได้ทันที
จากความสำเร็จในครั้งนี้ Sionic AI มุ่งมั่นที่จะเดินหน้าสนับสนุนการเปลี่ยนผ่านสู่ดิจิทัล (Digitization) ของหน่วยงานภาครัฐ ภาคการเงิน และการดูแลสุขภาพในประเทศไทย ซึ่งปัจจุบันยังคงมีเอกสารในรูปแบบกระดาษจำนวนมหาศาลที่รอการแปลงข้อมูลเข้าสู่ระบบ พร้อมวางแผนจับมือร่วมกับพันธมิตรในไทยเพื่อส่งมอบบริการที่ตอบโจทย์การใช้งานจริงขององค์กรไทยอย่างตรงจุด
Sukhyun Ko ประธานเจ้าหน้าที่บริหาร ของ Sionic AI กล่าวว่า “การได้รับคะแนนอันดับ 1 บน MDPBench ในฐานะ AI ที่มีความแม่นยำสูงสุดสำหรับการอ่านเอกสารภาษาไทย นับเป็นก้าวสำคัญอย่างยิ่งของบริษัทฯ ด้วยความร่วมมือกับพันธมิตรในประเทศไทย เราพร้อมที่จะช่วยให้หน่วยงานและองค์กรในไทยยกระดับประสิทธิภาพการทำงาน ลดต้นทุน และรักษาความปลอดภัยของข้อมูลได้อย่างสูงสุด เพื่อร่วมเป็นพันธมิตรระยะยาวในการขับเคลื่อนเศรษฐกิจดิจิทัลของไทย”